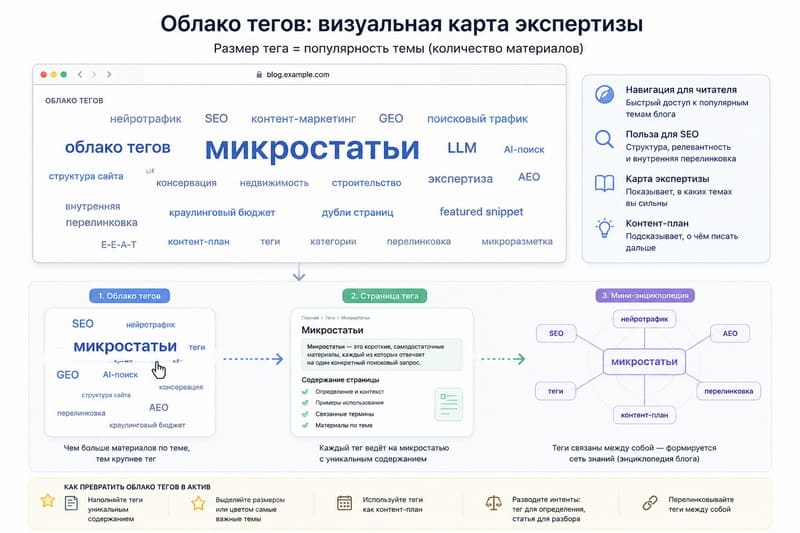
Знаете, сколько трафика вы теряете на страницах тегов? Я тоже не знал, пока не посчитал. Точнее, пока не понял, что почти четыре сотни моих тегов — теперь для меня больше не свалка пустых страниц, а готовый фундамент для моей личной мини-энциклопедии. Раньше они висели на сайте как гири на ногах: ни переходов, ни пользы, одно мельтешение в админке. Да ещё сеошники пугали, что этот мусор может привести к пессимизации сайта. Совсем недавно меня пробило, как можно превратить каждую страницу тега в работающий актив. Как я к этому пришёл и как повторить этот трюк — расскажу по порядку.
Что не так с тегами сейчас и почему это проблема
Когда-то теги придумали для удобства читателей и упрощения навигации. Но на деле большинство блогеров, включая меня образца прошлого месяца, просто ставили 5–7 меток и забывали про них. Со временем набегает триста, пятьсот, а то и больше тегов. В моём деловом блоге их число приближается к 400, а в личном — перевалило за тысячу. И вот тут начинается магия, только не чёрная.
Мусор или актив — как поисковики видят пустые страницы тегов
Обычная страница тега — это просто список анонсов статей. Уникального текста ноль. Для Google или Яндекса это дубликат контента, причём низкокачественный. Такие страницы не ранжируются, не дают трафика и впустую расходуют краулинговый бюджет. Поисковик тратит ресурс на их обход и не видит в них ценности. Полезного сигнала — ноль, а время и мощности уходят. Ваш сайт сообщает поисковику: «Смотри, у меня есть сотни пустых страниц!» Поисковик пожимает плечами и идёт индексировать что-то более достойное.
Каннибализация: когда теги отбирают трафик у ваших же статей
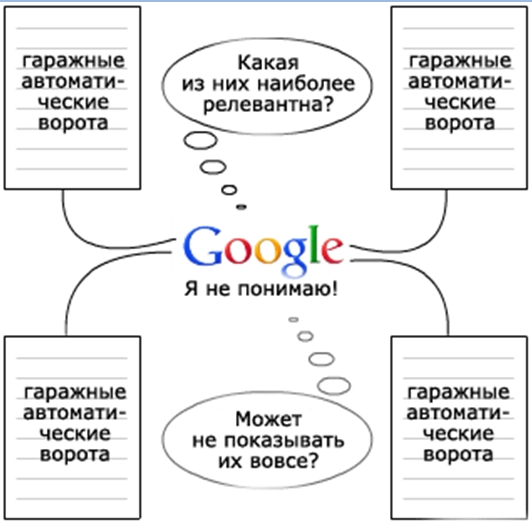
Есть и второй удар под дых. Если на теге «маркетинг» висят десятки статей, то поисковик может решить, что именно эта страница — главная по теме. И начнёт показывать её по запросу «маркетинг», хотя у вас есть отличный лонгрид «Основы маркетинга для малого бизнеса». Так тег начинает конкурировать с вашей же статьёй. В SEO это называют каннибализацией: вы сами у себя отъедаете трафик.
К счастью, обе проблемы решаются одним и тем же инструментом — микростатьёй. Если на странице тега появляется уникальный и полезный текст, она перестаёт быть «мусорной» и становится самостоятельным ресурсом. А каннибализация уходит, если развести интенты: страница тега отвечает на запрос «что это», а статья — на запрос «как применить». В большинстве случаев этого достаточно, чтобы поисковик развёл их по разным углам ринга и перестал сталкивать лбами.
Как превратить тег в мини-энциклопедию и зачем это нужно
Идея проста до смешного: для каждого тега пишется короткая статья — 500–1500 знаков. Она объясняет термин, даёт контекст и ссылается на ваши же развёрнутые материалы. Так тег из простого списка ссылок превращается в хаб, который:
- привлекает поисковый трафик по запросам вроде «что такое RFM-анализ» или «бережливое производство это…»;
- передаёт вес вашим профильным статьям через осмысленную перелинковку;
- служит доказательством вашей экспертности: раз у вас даже теги с умным содержанием, значит, вы серьёзный человек.
Более того, статью можно дополнить иллюстрацией с заполненными атрибутами alt и title. Это повысит её важность и релевантность.
Что даёт одна микростатья на странице тега
Представьте: на ваш блог заходит человек, который вбил в поиск «принцип Парето простыми словами». Он попадает не на обычную страницу с кучей анонсов, где ещё надо рыскать в поисках сути, а на чёткое определение: «Принцип Парето — это эмпирическое правило, согласно которому 20 % усилий дают 80 % результата». Плюс пара примеров, плюс ссылка на вашу же статью «Как я применил принцип Парето в логистическом аудите». Читатель получил ответ, вы получили доверие и потенциальный переход в статью. Красота.
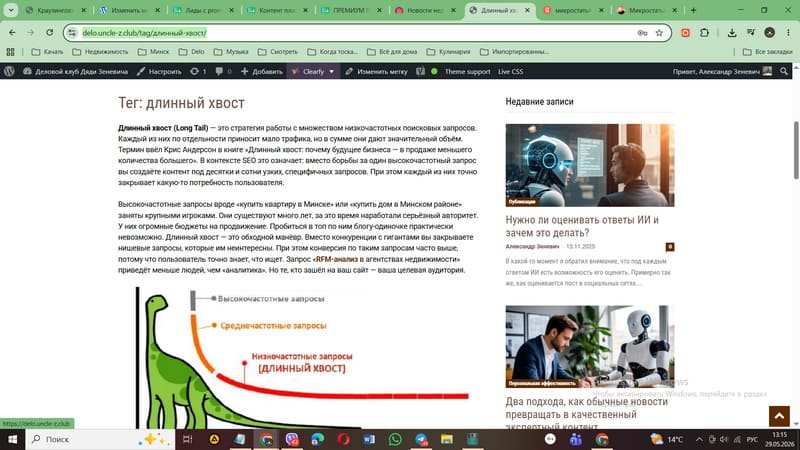
А теперь умножьте это на сотню тегов. Вы закрываете десятки и сотни низкочастотных запросов без необходимости писать под каждый отдельный лонгрид. Это и есть те самые «длинные хвосты» поискового трафика.
Нейротрафик как гипотеза: почему LLM могут начать цитировать ваши теги
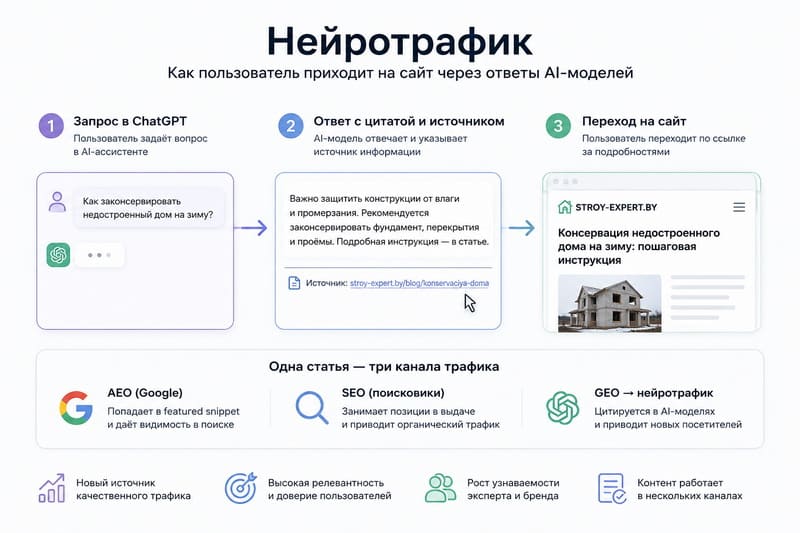
Здесь я выхожу на зыбкую почву гипотез. Моё предположение: страницы-определения — идеальный формат для цитирования большими языковыми моделями. Когда пользователь спрашивает у ChatGPT «что такое каннибализация запросов», модель ищет источник с чётким и однозначным определением. Если ваш тег содержит такое определение, оформленное как сниппет (одно-два предложения без воды), наиболее вероятно, что модель выберет именно его. А это — нейротрафик, явление пока новое, но крайне перспективное. Подтвердить это массовыми данными я пока не могу: слишком мало кто вообще заморачивается микростатьями для тегов. Да и я этим начал заниматься буквально на днях. Но логика подсказывает, что игра стоит свеч.
Кстати, та же логика работает и для классических поисковых систем: можно рассчитывать на то, что чёткие определения на страницах тегов попадут в быстрые ответы (Answer Engine Optimization, AEO). Да, часть пользователей удовлетворится сниппетом и не перейдёт на сайт. Но те, кому нужна глубина, — перейдут. А те, кто не перешёл, — могут запомнить источник. В итоге вы работаете на двух фронтах: видимость в поисковиках через AEO и цитируемость в AI через GEO.
Как это работает на практике: общий каркас без секретов
Весь метод я упаковал в несколько шагов. Сразу оговорюсь: детальные протоколы и нюансы персонификации контента я оставлю для своего будущего курса. Но базовая схема, которую вы можете применить уже сегодня, выглядит так.
Инвентаризация: аудит тегов и оценка спроса через Wordstat
Соберите все теги своего блога в одну таблицу. В моём деловом блоге их сейчас чуть меньше 400, у вас может быть тридцать или пятьсот — неважно. Важно честно оценить, по каким из них есть поисковый спрос. Для этого берём Wordstat, Google Trends или любой аналогичный сервис и смотрим частотность. Параллельно помечаем теги, по которым у вас уже есть статьи, и те, где пока пусто. Это база для будущего контент-плана.
Приоритизация: какие теги закрывать в первую очередь
Начинайте с тех, где высокий спрос и уже есть хотя бы одна статья на блоге. Так вы сразу дадите поисковику «хаб» с определением и ссылкой на развёрнутый материал. Теги без статей — это потенциальные темы для будущих публикаций. Я обычно беру 5–7 наиболее горячих тегов и закрываю их за один присест.
Кстати, пока писал этот материал придумал приём: верстаю готовую статью, но прежде чем её опубликовать, готовлю для неё микростатьи для страниц с тегами. Тогда когда на страницу со статьёй заходит краулер, то он запоминает не только статью, но и весь информационный кластер статья + страницы с тегами.
Структура микростатьи для тега (500–1500 знаков)
Для простоты я делю все теги на две группы: сущности (термины и продукты) и субъекты (персоны и компании). Для каждой — свой шаблон, но в основе три обязательных блока:
- Определение. Одно-три предложения, оптимизированные под сниппет. Никаких «может использоваться в разных сферах» — только конкретика. Пример: «RFM-анализ — это метод сегментации клиентов на основе трёх параметров: давности, частоты и суммы покупок».
- Контекст. Почему этот термин важен именно сейчас, какую роль он играет в современной деловой практике. Этот блок делает текст живым и экспертным. Без него — просто словарная справка, а словарей в интернете и так хватает.
- Ссылки на статьи. Автоматический вывод списка материалов с этим тегом. Ничего не надо изобретать — стандартный функционал WordPress или любой другой CMS.
Сколько времени это реально занимает
Вручную — примерно 40–60 минут на один тег. Надо найти определение, проверить факты, написать контекст, оформить. С AI-ассистентом и готовым шаблоном — 15–20 минут. Если опыта работы с нейросетями пока нет, первые микростатьи будут отнимать около часа, но уже через неделю практики скорость вырастет. Главное — не гнаться за скоростью в ущерб фактчекингу. Одна ошибка в дате или цифре — и доверие к вашей мини-энциклопедии рухнет, а вместе с ним и надежды на цитирование в LLM.
Впрочем, эта работа поддаётся автоматизации. Я сейчас тестирую несколько вордпрессовских плагинов, которые упрощают эту работу. Обязательно поделюсь своим опытом в отдельной статье.
Пять выгод, которые вы получаете, применяя эту методику (кроме трафика)
Я обещал рассказать, зачем это всё, кроме очевидного роста посещаемости. Их минимум пять.
1. Контент-план на основе данных, а не интуиции
Анализ частотности запросов с тегами через Wordstat или Google trends показывает реальный интерес аудитории к соответствующей теме. Вы видите, что люди ищут «виды логистического аудита», а у вас по этой теме — тишина. Это готовая идея для новой статьи. Так вы перестаёте гадать, о чём писать, и начинаете закрывать горячие запросы один за другим. Более того, вокруг самых популярных тегов можно целенаправленно строить контент-кластеры: микростатья-хаб плюс несколько новых публикаций, раскрывающих нюансы. Это классическая стратегия «тема против статей», но в миниатюре.
2. Прокачка навыков работы с нейросетями
Создание микростатей — идеальный полигон для тренировки промптов. Вы учитесь получать от модели чёткое определение, проверять его, добавлять свою экспертизу и упаковывать в формат, который нравится и людям, и поисковикам. Эти навыки потом легко переносятся на любые другие задачи — от написания коммерческих предложений до аналитики рынка.
3. Расширение собственного кругозора
Когда берёшься описывать три сотни терминов, волей-неволей начинаешь глубже разбираться в теме. Недавно я сел писать микростатью для тега RFM-анализ и вдруг понял, что путаюсь в критериях сегментации. Пришлось лезть в учебники, вспоминать кейсы из своей консалтинговой практики, формулировать простое объяснение. В итоге и статья получилась добротная, и сам освежил знания. Это как ремонт в квартире: вроде тяжко, зато потом всё блестит и работает.
4. Порядок в доме
Не могу не упомянуть чисто эстетический эффект. Когда вместо хаотичного облака тегов у вас красуется структурированная энциклопедия, админка блога начинает радовать глаз. Админка — лицо блогера. Ухоженное лицо приятнее, чем заросшее.
5. Закладка на будущее для AI
Даже если гипотеза о нейротрафике сработает не сразу, ваши микростатьи останутся в индексе. Когда поисковики и LLM начнут активнее работать в связке, у вас уже будет готовая база для цитирования. Это как купить участок земли на окраине города, через который лет через пять проложат шоссе.
Кому это подходит, а кому — пока рано
Даже если у вас всего 10 статей и 40 тегов — начинать всё равно стоит. Да, эффект будет малозаметным поначалу. Но 40 микростатей сделать гораздо проще и быстрее, чем 400. А главное — вы сразу закладываете фундамент: каждый новый тег будет рождаться уже с содержательной страницей, а не с пустышкой. Плюс подход работает независимо от количества опубликованного: анализ частотности тега подсказывает темы для новых статей, даже если у вас пока одна публикация с этим тегом в вашем блоге. Не ждите, пока накопите сотню материалов. Начните сейчас — и ваши теги будут расти вместе с блогом, а не превратятся в «кладбище несбывшихся надежд», как у многих.
Что дальше: как углубиться в методологию
Описанный каркас — это лишь вершина айсберга. В моей системе есть детальные протоколы для разных типов тегов, методика персонификации контента, алгоритмы работы с LLM на всех этапах — от сбора семантики до финальной проверки на цитируемость. Всё это я планирую упаковать в отдельный обучающий модуль в рамках курса по контент-маркетингу и использованию AI в работе эксперта. Если тема откликается — следите за анонсами на моём деловом блоге.
А вообще я очень жалею, что не допёр до этого раньше и начал заниматься этим только сейчас. О результатах своего эксперимента я расскажу где-нибудь через полгода-год, когда справлюсь со своим облаком тегов и
FAQ: три частых вопроса
«У меня всего 10 статей и 40 тегов. Стоит ли начинать?»
— Да. Создать 40 микростатей проще, чем 400, и это закладывает фундамент на будущее. Эффект будет накопительным: с каждой новой публикацией ваша мини-энциклопедия будет становиться всё более заметной для поисковиков.
«Не приведёт ли это к каннибализации?»
— В большинстве случаев нет, если соблюдать правило интентов. Страница тега — для запросов «что это», статья — для «как применить». Так они не будут конкурировать, а станут дополнять друг друга.
«А если я не эксперт во всех темах?»
— Это как раз повод углубиться. Описывая тег, вы сами прокачиваетесь в теме. Я не раз ловил себя на том, что, начав писать определение, закапывался в источники и узнавал новое. Например, когда описывал «диаграмму Исикавы», пришлось перепроверить, как правильно строить причинно-следственные связи. Оказалось, сам путал четвёртый и пятый шаги. Так что это нормально и даже полезно.
Краткий глоссарий
- AEO (Answer Engine Optimization) — оптимизация текста под быстрые ответы в поисковиках.
- GEO (Generative Engine Optimization) — оптимизация текста и страницы с ним под ответы AI-моделей.
- LLM (Large Language Model) — большая языковая модель. Пример — Claude, DeepSeek, ChatGPT. В разговорной речи именно LLM чаще всего называют искусственным интеллектом.
- Каннибализация запросов — ситуация, когда несколько страниц сайта конкурируют за один поисковый запрос.
- Интент — намерение пользователя, стоящее за поисковым запросом.
- Лонгрид — длинная экспертная статья, глубоко раскрывающая тему.
- Длинный хвост (long tail) — низкочастотные поисковые запросы, каждый из которых приносит мало трафика, но в сумме дающих значительный объём.
- Краулинговый бюджет — ресурс, который поисковик выделяет на обход своим роботом-краулером страниц сайта.
- Featured snippet — блок с кратким ответом в верхней части поисковой выдачи.
- Wordstat — сервис Яндекса для оценки частотности поисковых запросов.